大数据开发中最常用的编程语言与数据处理和存储服务
引言
随着数据量的爆炸式增长,大数据开发已成为企业挖掘数据价值的关键环节。在大数据生态中,选择合适的编程语言和数据处理、存储服务至关重要。本文将介绍大数据开发中最常用的编程语言,以及主流的数据处理与存储服务,帮助开发者快速构建高效的数据管道。
一、大数据开发中最常用的编程语言
1. Java
Java 是大数据生态的基石,Hadoop、Spark、Flink、Kafka 等核心框架均主要使用 Java 开发。Java 拥有成熟的 JVM 生态、丰富的类库和强大的跨平台能力,适合构建大规模分布式系统。
2. Scala
Scala 运行在 JVM 上,兼具面向对象和函数式编程特性。由于 Apache Spark 和 Apache Kafka 均使用 Scala 编写,Scala 在数据工程领域广受欢迎。其简洁的语法和强大的并发模型能够显著提升开发效率。
3. Python
Python 凭借简单易学、丰富的科学计算库(如 Pandas、NumPy)和活跃的社区,成为数据分析和机器学习首选语言。PySpark、Dask 等框架让 Python 也能处理大规模数据,适合快速原型开发和数据探索。
4. SQL
虽然 SQL 不是通用编程语言,但在大数据开发中地位不可替代。Hive、Spark SQL、Presto/Trino、Flink SQL 等允许开发者用声明式语句进行数据查询和转换,极大降低了大数据处理门槛。
5. Go 和 Rust
随着云原生和实时数据处理的发展,Go 和 Rust 逐渐进入大数据领域。Go 适合构建高并发的数据采集和微服务,Rust 则用于对性能要求极高的场景(如流处理引擎)。
二、数据处理服务
数据处理服务负责对海量数据进行清洗、转换、聚合和分析。常见服务包括:
- Apache Hadoop MapReduce:经典的批处理框架,适合离线大规模数据处理,但延迟较高。
- Apache Spark:基于内存的分布式计算引擎,支持批处理、流处理、机器学习和图计算,性能远超 MapReduce。
- Apache Flink:原生流处理框架,提供 exactly-once 语义和低延迟,适合实时数据处理。
- Apache Kafka Streams:基于 Kafka 的轻量级流处理库,适合构建实时数据管道。
- Apache Beam:统一的编程模型,可运行在 Spark、Flink 等引擎上,实现批流一体。
- 云托管服务:如 AWS Glue、Google Cloud Dataflow、阿里云实时计算 Flink 版,提供免运维的数据处理能力。
三、数据存储服务
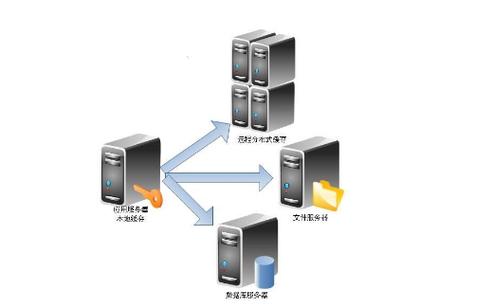
数据存储服务为大数据提供持久化、高可靠、可扩展的存储方案。主要分为以下几类:
- 分布式文件系统:HDFS(Hadoop Distributed File System)是大数据存储的基石,适合海量文件存储。
- NoSQL 数据库:
- HBase:基于 HDFS 的列式数据库,支持海量数据的随机读写。
- Cassandra:高可用的分布式列存储,适合写多读少场景。
- MongoDB:文档型数据库,适合半结构化数据。
- 对象存储:如 AWS S3、阿里云 OSS、腾讯云 COS,提供低成本、高扩展的存储,常与 Spark、Hadoop 集成。
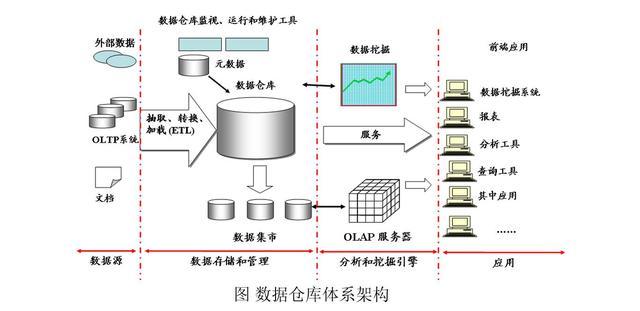
- 数据仓库:
- Apache Hive:基于 Hadoop 的数据仓库,提供 SQL 接口。
- ClickHouse:列式 OLAP 数据库,查询速度极快。
- Apache Doris / StarRocks:新一代 MPP 数据仓库,支持实时分析。
- Snowflake / BigQuery / Redshift:云原生数据仓库,弹性扩展。
- 时序数据库:如 InfluxDB、TimescaleDB,用于存储监控指标和 IoT 数据。
- 图数据库:如 Neo4j、JanusGraph,用于社交网络和知识图谱。
四、如何选择
选择编程语言和数据处理存储服务时需考虑以下因素:
- 数据规模与延迟要求:批处理可选择 Java/Scala + Spark/HDFS;实时处理可选 Flink/Kafka;交互式分析可选 Presto/ClickHouse。
- 团队技能:Python 团队可优先使用 PySpark 和 Pandas;Java 团队更适合 Hadoop/Spark 原生开发。
- 成本与运维:云托管服务减少运维负担,但可能产生较高费用;自建集群初期成本低,但需专业运维。
- 生态整合:确保所选语言和存储服务能与现有系统(如数据湖、消息队列)无缝集成。
##
大数据开发中,Java 和 Scala 是构建核心框架的主力,Python 和 SQL 则因易用性成为数据分析和查询的利器。数据处理服务从批处理的 Hadoop/Spark 到流处理的 Flink/Kafka,存储服务从 HDFS 到云数据仓库,提供了丰富的选择。开发者应根据业务需求、团队能力和成本预算,组合使用这些语言和服务,构建高效、可靠的大数据平台。